onsdag 20 augusti 2014

Räknefel då man stickar

Välkomna till Statistikbloggen! 

Jag läste en fråga på Facebookgruppen ”Stickcafé” som handlade om hur många gånger man ska kontrollräkna maskorna på sin stickning. Så – i ett försök att bredda läsekretsen – tänkte jag försöka ge lite synpunkter på detta. 

Om man stickar måste man (om man är lika amatörmässig som jag i alla fall) kontrollräkna antalet maskor med jämna mellanrum. Om antalet är för litet har man sannolikt tappat en maska som man i så fall måste leta upp och sticka in, men man kan även råkat lägga till en. Ska man sticka en resår vållar detta stora problem eftersom man ska sticka varannan avig, varannan rät och om man har ett fel så blir det både snett och vint.

Så därför måste man ibland kontrollera antalet. 

Antag att vi stickar en vante (eller socka) med 40 maskor per varv, fördelade på 4 stickor med 10 vardera. För enkelhets skull antar vi att det är fråga om slätstickning så det är bara räta maskor hela varvet runt. Nu ska vi kontrollräkna antalet… 


För varje maska kan vi göra två fel: Missa att räkna (antalet minskar med ett), räkna dubbelt (antalet ökar med ett) eller räkna rätt. Vi betecknar dessa med (-1, +1 respektive 0). Gör vi alla rätt kommer vi att få rätt svar. Men hur kan vi veta att vi faktiskt har rätt bara för att vi får rätt summa? Vi kan ju ha räknat fel två gånger! 

Inom informationsteori talar man om felupptäckande och felrättande koder. En upptäckande kod innehåller en kontrollmöjlighet som gör att vi kan upptäcka vissa fel, men vi kan inte rätta dem. Exempel på detta är kontrollsiffran i personnumren och OCR-numren. Man kan se att det är fel på ett personnummer om kontrollsiffran är fel, men man kan inte se vad det rätta numret är. En rättande kod så kan man även korrigera felet så att det blir rätt. Men om två siffror ändras samtidigt så kan kontrollsiffran bli rätt i alla fall och felet går obemärkt förbi… 

Ett exempel på en felupptäckande kod inom stickning är att om man stickar resår (varannan rät och varannan avig). Om sista maskan blir rät vet man att det är fel någonstans, men inte var eller hur detta ska korrigeras. Men även här kommer två fel att ta ut varandra. 

Låt oss anta att du oftast räknar rätt. Säg att felräkningar inträffar 1 gång på 1000 (var 1000:e maska missas ELLER dubbleras, medan 999 räknas rätt). Det betyder att en kontrollräkning av vanten ovan kommer att ha noll fel med en sannolikhet på 96,1%. Sannolikheten för EXAKT ett fel är 3,8% och sannolikheten för MINST 2 fel är 0,076%. Se tabellen nedan. 

Men även om man gör minst 2 fel så kan det fortfarande vara så att felräkningarna syns. Ett udda antal fel kommer t.ex. alltid att synas. Likaså om samma fel görs fler gånger (man missar t.ex. att räkna 2 maskor). Gör man däremot fel så kommer det att vara ETT fel eller ett antal fel som syns i alla fall med mycket hög sannolikhet (över 99%). Så om man bara gör fel 1 gång på 1000 så kommer man med största sannolikhet att få rätt resultat, d.v.s. upptäcka ett fel som finns eller godkänna ett korrekt arbete. Ett räknefel kommer alltså inte att gå att missa. 

Om du är slarvigare och gör fel på var hundrade maska så blir kontrollräkningarna trots det rätt med en sannolikhet på 67%. Även i detta fall kommer det att vara mycket sannolikt att OM man gör ett fel så är det bara ett fel (81,7%). 


Men slarvar man ännu mer och gör fel på var 10:e maska så blir det problem. Då kan man troligen inte lita på sin kontrollräkning alls utan måste kontrollräkna flera gånger oavsett resultat.  
Jag tror att de flesta med lite noggrannhet kommer att räkna rätt så ofta att om man gjort fel så upptäcks detta. Kontrollera gärna själv genom att räkna samma stycke flera gånger. Därför drar jag slutsatsen att om man stickar vantar eller raggsockor så ska EN genomräkning räcka. Skulle det bli ett felaktigt antal så måste man gå igenom arbetet en gång för att finna felet, som sannolikt kommer att finnas. 

 Hälsningar Magnus 

 Tack till Monica Larsson som gav mig inspiration till denna bloggpost!

måndag 12 maj 2014

Nicholas Cage och drunkningsdöden


Hej Statistikvänner!

Jag fick ett kul länktips av min kompis Torsten Beckman (http://www.tylervigen.com/).

Siten presenterar 20 stycken korta tidsserier där det finns en tydlig korrelation mellan några – väldigt märkliga. Bland annat är det så att fler drunknar i swimmingpoolar de år då det kommer ut fler filmer med Nicholas Cage. Man kan fundera länge över hur detta kommer sig, men svaret är lika enkelt som tråkigt.

Nicholas Cage -
The man, the myth, the statistic

Bara för att det finns en korrelation i data så har man inte automatiskt ett orsakssamband. Det är alltså inte så att Nicholas Cages agent arbetar mer aktivt om folk drunknar. Lika lite tror jag att hans filmer får folk att drunkna – varken avsiktligt eller oavsiktligt.

Ibland finns det en effekt som kallas ”skensamband”. Bakom två variabler ligger en tredje som man inte tittar på. Det finns ett logiskt samband mellan denna och bägge de andra, men inte mellan de man betraktar… Om du inte hängde med: Det finns bevis för att kaffedrickare oftare får lungcancer. Orsaken till detta är att rökare BÅDE dricker mer kaffe och får lungcancer, inget annat. Jag gillar inte att vara kategorisk, men jag tror inte att det finns någon tredje faktor som ger Nicholas Cage filmkontrakt och får folk att drunkna.

Svaret ligger i att dataserien är kort (11 år) och att de är många.

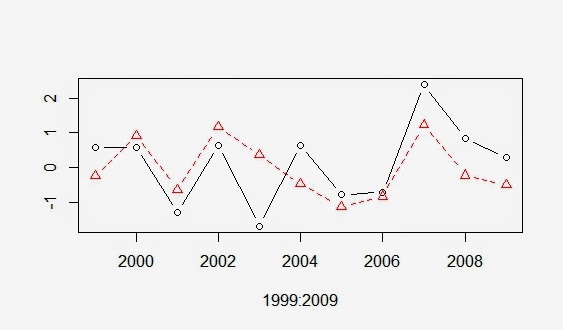
Jag roade mig med att göra en simulering på helt oberoende data upprepat 20 gånger. Den bästa av körningarna hade en korrelationskoefficient på 0,54 se figuren. Faktum är att om man gör om samma sak med bara 5 serier som testas i alla par som är möjliga (20 st) så blir det 65% i det bästa fallet.

Simulerade data för 1999 till 2009. Helt oberoende... Trots det blev det en fin korrelation.


De har presenterat 20 resultat, sammanlagt 40 variabler. Antalet möjliga par är 780 stycken. Det är inte konstigt att det finns de med hög korrelation.

Man bör vara försiktig med att tolka denna ”information” eftersom det kan leda till felaktiga slutsatser. Dessa slutsatser kan i sin tur orsaka stora skador. Man skulle behöva en varningstext som de som sitter på cigarettpaketen. ”Varning – Dålig statistik kan skada dig allvarligt!”.

Magnus

onsdag 22 januari 2014

Facebook dör ut mellan 2015-17

Hej,

Facebook på väg att dö ut som en smittsam sjukdom! Få saker väcker ett intresse som en bra rubrik.

Inom statistiken använder man modeller, d.v.s. en förenklad bild av hur verkligheten fungerar. I modellen finns slumpmässiga förlopp, påverkan m.m. inlagda och sedan skattar man hur stora dessa är.

Inom epidemiologi – läran om smittsamma sjukdomars spridning – finns en enkel modell som delar in alla människor i tre faser: Mottaglig, Smittad, Resistent. Först kan man bli smittad av sjukdomen, sedan är man smittad och sprider smittan vidare till andra mottagliga och sedan blir man Resistent mot smitta. Till detta finns mängder av variationer. T.ex. kan resistent betyda att man avlidit.

På engelska kallas detta ”SIR”-modellen (Susceptible, Infected, Resistent).

Beroende på hur lätt det är att smitta andra och hur ofta detta sker och hur lång tid smittade har på sig att sprida sjukdomen vidare blir det olika förlopp. Rabies och hiv sprids ganska sakta eftersom smittotillfällena är få. Å andra sidan influensa sprids snabbt och kan explodera i pandemier för att sedan dö ut då stora delar av befolkningen utsatts för smittan och antingen blivit immuna eller dött.

Forskare vid Princeton University [1] har tillämpat samma modell på Facebook. Man kan betrakta en person utan Facebook-konto som ”Mottaglig för smitta”, en som anslutits som ”smittad”. Om man tillämpar denna modell kan man se hur snabbt farsoten sprider sig innan en pandemi mer eller mindre brutit ut. Men de har även beräknat att trenden vänder och denna vändning finns med i modellen.

Likt spanska sjukan och böldpesten kommer smittan att avklinga. Enligt forskarna har detta redan skett med MySpace som följde samma mönster för några år sedan. Facebook nådde sin topp 2012 och kommer att tappa 80% av sina användare mellan 2015 och 2017.

/Magnus

[1] J Cannarella and J A Specler (2014). Epidemiological modeling of online social network dynamics. http://arxiv.org/pdf/1401.4208v1.pdf

måndag 16 december 2013

Är tåget i tid?

Hej Statistikvänner,

För ett par år sedan tänkte jag skriva lite om tågförseningar. Nu har Riksrevisionen precis släppt en rapport över detta ämne och konstaterar den rapportering och styrning som förekommer. Ett av kapitlen i rapporten har den talande rubriken "Är punktlighetsstatistiken tillförlitlig och medborgarnära?". I sammanfattningen kan man läsa följande sågning:

"Svagheter i Trafikverkets statistikarbete gör dock att myndighetens uttalanden om punktlighetens förbättringar under senare år är osäkra. En anledning är att ... punktligheten inte har vägt in förekomsten av ... inställda tåg,... hur olika omständigheter... påverkar punktligheten. Det innebär enligt Riksrevisionen att det är svårt att från Trafikverkets redovisning av punktlighetsstatistik dra en slutsats om det har skett någon egentlig förbättring ..." [1]

Trafikverket räknar ett tåg som antingen "punktligt" eller försenat. Om tåget är mindre än en viss tid sent så räknas det som "i tid" och därefter "försent". Inga gradskillnader förekommer. Tidigare var ett tåg försenat efter 5 minuter, men denna gräns har ändrats till 15. Det betyder alltså att tidigare var ett tåg som var 4 minuter och 59 sekunder sent "i tid". Medan ett tåg som var 5 minuter och 0 sekunder sent var "försent". Samtidigt var ett tåg som var 2 timmar sent lika sent som ett på 5 minuter.

Detta kallas "dikotomisering". En kontinuerlig variabel ersätts med en som bara har två värden, "i tid" och "försent". Varje tågresenär vet att det inte är något magiskt som inträffar då sekundvisaren flyttar från 4.59 till 5.00. Graden av skada ökar med ökande försening, med vissa hopp inlagda då anslutningar, tandläkartider etc passeras. Det betyder att man tar bra information och gör om den till irrelevant information.

Men det är inte det enda felet...

Betraktar ett pendeltåg som startar i Alingsås och som efter 10 stopp slutar på Göteborg C. Med detta tåg finns 66 olika resandekombinationer. Men om tåget är försenat så räknas det som en försening (slutstationen). Man kan se det som att man drar ett streck på tavlan för ett sent tåg, men man glömmer 11 eller 65 beroende på hur man ska räkna.

Dessutom är det - sett ur resenärens perspektiv - intressant hur många som sitter på tåget. Ett i stort sett tomt tåg påverkar få människor, medan ett fullsatt tåg kanske gör 500-600 personer försenade till jobbet, dagis, tandläkaren eller vart man nu ska. Om ett fullsatt pendeltåg försenas 14 minuter (vilket inte är sent enligt definitionen) så skapar det en total försening på 150 timmar - Varje minut kostar 2 timmars tidsförlust.

Till detta kommer att inställda tåg räknas för sig. Men sätt ur passagerarnas perspektiv är en inställd avgång samma sak som en försening. Hur lång den är beror på frekvensen av avgångar. Under dagtid avgår ett kommande pendeltåg om 30 minuter, vilket betyder att ett inställt tåg är samma sak som en försening på 30 minuter gånger antalet passagerare.

Problemet med felaktiga mätetal är att de leder till felaktiga beslut.
  • Eftersom man inte värdesätter förseningar efter deras storlek finns ingen grund för att minimera den. Ett sent tåg är redan bortom räddning.
  • Eftersom man räknar tåg och inte passagerare spelar det ingen roll om tåget är fullsatt eller inte. Resenärernas perspektiv svarar inte mot Trafikverket. Punktligheten är sannolikt mycket lägre beräknat per passagerare.
  • Eftersom ett inställt tåg räknas för sig är det smartare att ställa in och sätta passagerare på nästa tåg som förhoppningsvis är i tid. Då är ingen mätbar skada skedd.
Här har vi en del av förklaringen till varför tågen är mer sena än vad de styrande tror...

Magnus

1.  Tågförseningar – orsaker, ansvar och åtgärder. Rir 2013:18.

tisdag 19 november 2013

Kejsarens nya kläder

Hej Statistikvänner,

Behovet av undersökningar som ger snabba resultat på aktuella frågor bara växer och växer. Traditionellt har dessa genomförts via post, sedan telefon och numera internet. En populär variant som ökar i omfattning är de s.k. webb-panelerna.

En panel består av ett antal personer som deltar i flera undersökningar i t.ex. sex månader. Eftersom de är kända och visat intresse för att delta är det lätt att snabbt få svar. Om man dessutom genomför undersökningen via e-post eller webb så blir det dessutom enkelt och billigt.

Tyvärr blir det lätt fel…

Första problemet ligger i hur urvalet av de s.k. panelisterna - I den bästa av världar är dessa ett slumpmässigt urval. För att rekrytera ett sådant måste man i så fall göra ett slumpmässigt urval av befolkningen, kontakta dem på ett sätt som gör att svarsbortfallet blir acceptabelt lågt och rekrytera med en någotlunda jämn fördelning mellan alla grupper. Att detta är svårt inses lätt då man ser vilka som kan tänka sig att ingå i en panel och bli uppringde upprepade gånger för att svara på frågor.

Tyvärr rekryteras stora delar av panelerna av frivilliga, alltså personer som sökt sig till panelen för att få delta. Är dessa ett slumpmässigt urval av befolkningen – Absolut inte. De som lockas är antingen personer med överskott på tid, underskott på pengar eller extremt tyckmyckna personer.

Men kan man inte justera för detta? Om panelen består av ett överskott med sverigedemokrater, kvinnor i småstäder, äldre än 55 utan högskoleutbildning så kanske man kan lösa detta. Men då ska man komma ihåg att allt bygger på modellantaganden.

Om kvinnor är underrepresenterade (t.ex. 1 kvinna per 2 män) så skulle man enkelt kunna justera alla kvinnor med en faktor 2. Men vad säger att det inte orsakar nya problem, t.ex. som följd av att kvinnor har lägre inkomster i genomsnitt? Dessutom orsakar de uppjusterade kvinnorna en högre variation - Eftersom vi frågar färre, men multiplicerar upp dem, så kan enstaka lite mer ”extrema” svar få en hävstångseffekt. Sist men inte minst så kan denna justering bara ske mot hårda data, som kan sökas – exakt – i målpopulationen, t.ex. ålder, kön och bostadsort. Minsta lilla ”mjuka” data så är det kört. Inkomst går inte, partitillhörighet går inte, socialgrupp går inte.

Faktum är att jag tror att vissa grupper är helt orepresenterade och därför ”återskapas”.

Men framför allt är panelisternas åsikter ungefär lika representativa som rösterna på Idol 2013 eller som insändarsidan i en genomsnittlig lokaltidning. Trots detta så blåser man gärna upp resultaten som ”fakta”. Vad värre är: Denna falska information används som underlag för att styra samhällets utveckling och påverkar debatten kring hur vi ska leva och organisera vår gemensamma värld.


Som Fröding sa: Strunt är strunt och snus är snus, om ock i gyllne dosor.

tisdag 12 mars 2013

Florence Nightingale (apropå kvinnodagen)

Ett par dagar försent... Men här är i alla fall ett inlägg om internationella kvinnodagen.

Jag fick ett mail från kampanjgruppen för Year of Statistics 2013 där man uppmanade till att uppmärksamma alla kvinnliga statistisker på kvinnodagen. En av de mer kända (men kanske inte som statistiker) är Florence Nightingale (1820-1910).

Bland de viktigaste upptäckter som Nigtingale presenterade handlar om förhållandet mellan hygien och sjuklighet. Vi vet idag att bakterier, virus och andra smittämnen sprids och hur detta går till, men i slutet av 1800-talet var detta helt okänt.

En tydlig illustration på detta är pajdiagrammet nedan. Pajdiagram var nyligen uppfunna, men Nightingale tog dem till en ännu högre nivå. Diagrammet sammanfattar med en obehaglig tydlighet krigets fasor. Även om man rekryterade soldater för det "ädla" målet att stupa på slagfältet så var det inte där de dog - De dog i sjuksängarna. Av infektioner. Av undernäring och av brist på hygien.


Förutom de fakta som diagrammet ovan visar är det ett vackert och funktionellt diagram. Idag kan man svänga ihop ett sådant på ett par minuter med lämplig programvara, men hur lång tid det tog att fixa detta på 1850-talet vågar jag inte gissa.

Nightingale presenterade flera resultat som på ett tydligt och klart sätt visade vikten av hygienska reformer inom sjukvården. Alltid med samma klara precision.

Hon var även den första kvinnan som valdes in i Royal Statistical Society, så nog förtjänar hon uppmärksamhet på internationella kvinnodagen under interntaionella statistikåret.

Hälsningar

Magnus

torsdag 10 januari 2013

Littlewoods lag


Hej Statistikvänner,

Wow! Jag fick en hand i poker med Spader Ess, Ruter 9, Spader 7, Klöver 5 och Hjärter 2!!!! Helt otroligt!

Så skulle du knappast säga om du får denna hand. Jag vågar till och med gissa att du är ganska säker på att du har fått denna eller en liknande hand om du spelat poker. Men tänk efter: Denna hand är LIKA sannolik (eller osannolik) som Royal Imperial Straight Flush (10 till Ess i Hjärter). Eftersom denna hand är unik – det finns bara 1.

Det finns exakt 2 598 960 möjliga pokerhänder så det är ganska otroligt att du hunnit spela alla. Saken är den att ALLA pokerhänder är lika sannolika, men de är olika värda. Handen på bilden är skräp, men lika sannolik som Royal Imperial Straight Flush. Det finns 4 Royal Straight Flush (en i varje färg), 40 Straight Flush. O.s.v. så det krävs ganska många givar innan dessa dyker upp.

Hur många par finns det? (Se längst ner för svar).

Det är samma sak med en lotto-rad som innehåller 3, 9, 17, 18, 26, 30, 32. Inget speciellt med den, till skillnad från raden 1, 2, 3, 4, 5, 6, 7, men även dessa rader är lika sannolika (1 på 6 724 520).

Det intressanta med denna lilla övning är att man bör fundera över annat som sker i tillvaron och som ser helt otroligt osannolika ut. Med tanke på alla små händelser som sker så är det ganska få saker som är unika. Den brittiske matematikern John Littlewood (1885-1977) satte siffror på detta och formulerade Littlewoods lag. Enligt denna kan en händelse betraktas som ett mirakel om det har en sannolikhet mindre än 1 på miljonen. Antag att vi är vakna och fult alerta 8 timmar per dag och att vi upplever en händelse per sekund. I så fall kommer vi att uppleva ett mirakel i månaden.

Om vi betänker alla små händelser som bara flimrar förbi som fullt normala så blir det ganska många som vi inte ser. Vi tänker inte på att det kör förbi en röd bil, eller att den kördes av en man i mustasch, samtidigt såg vi en kvinna med en hund (schäfer) o.s.v. Varje sådan händelse är lika unik som alla de märkliga – men vi lägger dem inte på minnet.

Värt att tänka på då vi sitter vid pokerbordet.

Jag återkommer med mer märkliga fakta om detta i nästa inlägg… Missa det inte…

Hälsningar

Magnus


=== 
PS. Antalet möjliga par i poker är 1 098 240, vilket ger en sannolikhet på 42% DS